站点介绍
全大写的邮件标题像在吼人——收到的人第一反应不是读内容,而是觉得出了事故。另一件常发生在程序员身上的事:把四十个 user_name 风格的字段改成 camelCase,手敲到第三个必然漏一个字母,然后一个属性悄悄读成 undefined,报错的位置离病因隔了三个屏幕。这两件事,都是一次粘贴就能解决的事。
大小写不是排版装饰,是英文的语法的一部分。Sentence case 是人正常写信写文档的语域,邮件主题、CHANGELOG、错误提示用它最合适。全大写只留给警告和机房横幅。而代码这边,JavaScript 变量惯用小驼峰,Java/C# 类名用大驼峰,Python 和 SQL 列名用下划线,CSS 类名和 URL 用连字符,环境变量用全大写下划线——每个圈子都有自己的规矩,lint 会因为其中一种拒收你的提交。
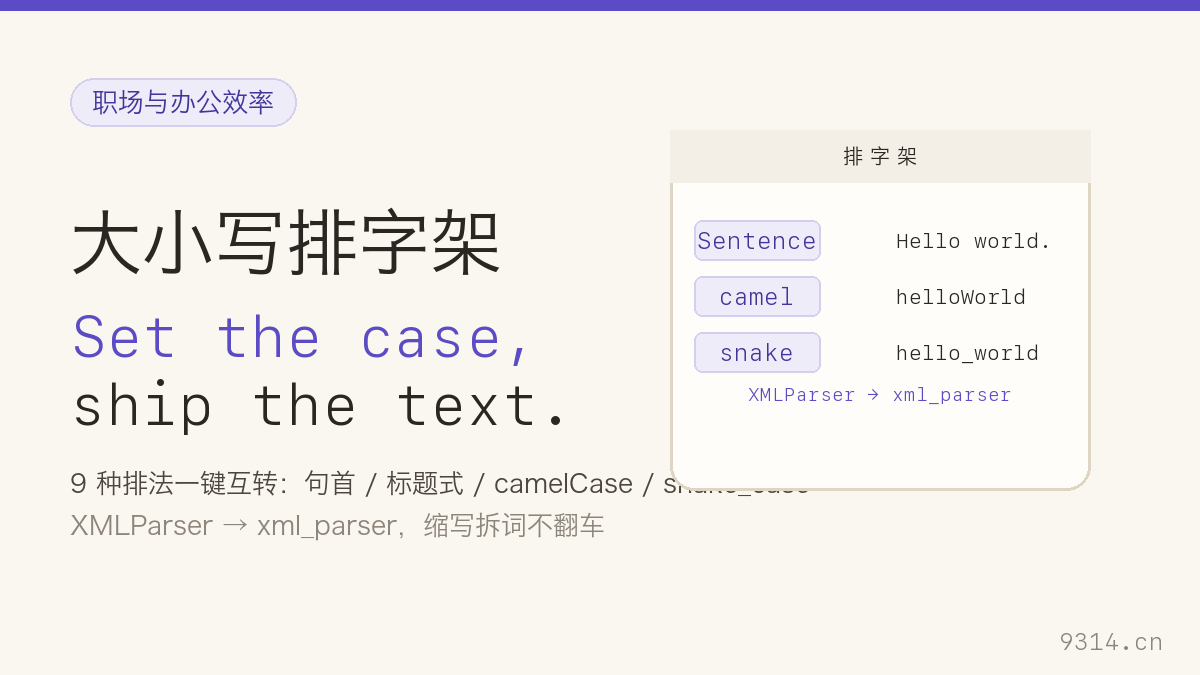
把整段文字变大写是一个方法调用的事。真正难的是把词拆回来:XMLHttpRequest 在人眼里是三个词,在笨分词器眼里是一堵字母墙。连续大写是陷阱——XML、HTTP、JSON 各是一个词,分词器得知道 Parser 的 P 属于下一个词而不是缩写的一部分。拆错了就得出 x_m_l_http_request 这种没人认得的东西。
这个工具的分词器把连续大写当缩写整体、把「大写+小写」的开头大写交给下一个词,实测过 XMLParser、getJSON、parseJSONData、myURLFetcher 这些经典难例。混写输入也吃得下:snake、kebab、空格、camel 混在同一段里照样拆对,因为真实世界的标识符从来不是单一风格。
机器认不出专名:Sentence case 会把 NASA 压成 nasa,标题式会把 iphone 排成 Iphone——工具没有可信的专名词典,诚实的做法是让你手动补这几处,而不是假装认识所有品牌。camel、snake、kebab 输出的是单个标识符,词间空格和标点会收进连接符里——句子转 snake_case 得到 the_quick_brown_fox,做 slug 正合适,当句子就别怪它。中文没有大小写,转换只碰 26 个英文字母,汉字、emoji、数字原样保留。
分词器把连续的大写字母当作一个缩写整体看待:XML 是一个词,Parser 是另一个词,所以结果是 xml_parser。同类例子 getJSON 会拆成 get 和 JSON 两个词。这一步是大小写转换工具最容易翻车的地方,本工具有专门针对缩写的拆词逻辑。
不会。中文没有大小写,转换只改英文字母,汉字、中文标点、emoji 都原样保留。混排文本里中文部分不受任何影响。但这个工具本身是面向英文文本设计的,纯中文粘进来不会有任何变化。
不会。Sentence case 只把每句的第一个字母大写,其余保持小写,接近自然书写。注意:句中原本全大写的缩写(如 NASA)也会被压成小写(nasa),因为工具无法判断哪个词是专名——需要保留缩写请用标题式或手动微调。
区别只在第一个词:camelCase(小驼峰)首词小写、后续词首字母大写,如 userName;PascalCase(大驼峰)每个词首字母都大写,如 UserName。JavaScript 变量惯用小驼峰,Java/C# 类名惯用大驼峰。本工具两种都能一键转。
会拒收并提示。1MB 约够 50 万个英文单词,正常使用碰不到上限;设这个限制是为了防止粘贴整本书把浏览器卡死。超长文本请分几次粘贴转换。
不会。转换、统计、复制、下载全在这台设备的浏览器里完成,零网络请求,文字不写本地存储。只有上次用的转换模式记在浏览器里,下次打开保持你的习惯;页脚「清空我的数据」可以删掉。
English version: https://www.9314.cn/tools/case-converter/en/
相似站点
评论列表 (0条)
 "英文大小写转换:9 种格式一键互转,代码命名不翻车")
 "英文大小写转换:9 种格式一键互转,代码命名不翻车")